
Dati personali e intelligenza artificiale: come proteggere le informazioni dei clienti mentre i sistemi lavorano
Copiare una conversazione con un cliente in un assistente di intelligenza artificiale vuol dire far uscire dati dall’azienda prima ancora che arrivi la risposta. Il rischio si riduce conoscendo il percorso delle informazioni, mascherando ciò che non serve, limitando gli accessi al minimo necessario, scegliendo con attenzione il fornitore e facendo controllare il risultato a una persona.
 Roberto GhilardiniAggiornato il 21 minuti di lettura
Cosa trovi in questo articolo
- Cosa succede ai dati quando si usa un assistente di AI
- La differenza tra dati personali, dati particolari e informazioni riservate
- Come funziona il mascheramento e perché non è anonimizzazione
- Un esempio completo, dalla contestazione alla bozza di risposta
- Come scegliere il fornitore e limitare gli accessi
- Come verificare che la protezione funzioni e come spiegarla al personale
Che cosa accade quando chiediamo aiuto a un sistema di intelligenza artificiale
Immagina una persona che lavora nell’ufficio commerciale di una piccola azienda. Un cliente le ha scritto una lunga email per contestare una consegna. Nel messaggio ci sono il nome della società, l’indirizzo del referente, il numero dell’ordine, le condizioni pattuite e il valore della fornitura. L’impiegata vuole preparare una risposta accurata e pensa di incollare tutta la conversazione in un assistente di intelligenza artificiale, chiedendogli di riassumere i fatti e proporre una bozza.
Il vantaggio è evidente: in pochi istanti può ottenere una ricostruzione ordinata di una vicenda che altrimenti richiederebbe di leggere molti messaggi. Il rischio, però, nasce prima della risposta. Per produrla, il sistema deve ricevere informazioni che appartengono al rapporto tra l’azienda e il cliente. Il semplice gesto di copiare un testo in una chat può quindi comportare la comunicazione di dati a un fornitore esterno.
È importante descrivere correttamente ciò che succede. Non significa che ogni servizio di intelligenza artificiale diffonda i dati ricevuti o li utilizzi necessariamente per addestrare i propri modelli. I trattamenti dipendono dal prodotto, dal contratto, dalle impostazioni e dall’architettura tecnica. Significa, più concretamente, che l’azienda deve conoscere il percorso delle informazioni prima di autorizzarne l’invio. Il fatto che l’interfaccia sia semplice non rende automaticamente semplice il trattamento che avviene dietro lo schermo.
Per comprendere il problema bisogna distinguere la richiesta dalla documentazione utilizzata per soddisfarla. La richiesta può essere innocua: «Prepara una risposta cortese a una contestazione». Il materiale che la accompagna può contenere informazioni che l’azienda ha il dovere di proteggere. Questo vale per le email, ma anche per preventivi, contratti, fatture, buste paga, verbali di riunione e relazioni tecniche. Più un assistente è utile perché conosce il contesto, più diventa necessario decidere quale parte di quel contesto può ricevere.
Dati personali, dati particolari e informazioni riservate: tre categorie diverse
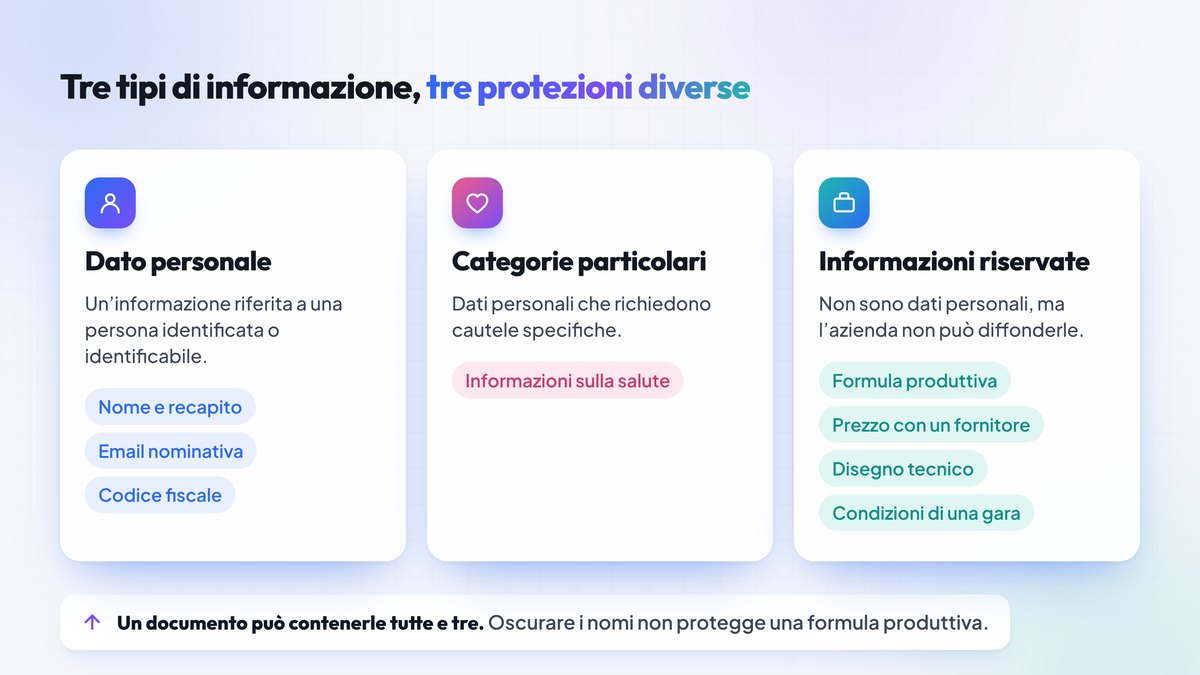
Nel linguaggio quotidiano si usa spesso l’espressione «dati sensibili» per indicare qualunque informazione che non si vuole rendere pubblica. Quando si ragiona di protezione dei dati, però, una distinzione più precisa aiuta a progettare procedure corrette. Un dato personale è un’informazione riferita a una persona fisica identificata o identificabile. Un nome unito a un recapito, un indirizzo email nominativo, un codice fiscale o un insieme di dettagli che permette di risalire a qualcuno può rientrare in questa categoria.
Esistono poi categorie particolari di dati personali, per esempio le informazioni relative alla salute. Il loro trattamento richiede cautele specifiche. Infine ci sono dati aziendali che possono essere estremamente riservati pur non essendo dati personali: una formula produttiva, il prezzo negoziato con un fornitore, un disegno tecnico, una strategia commerciale, le condizioni di una gara o il progetto di un nuovo prodotto. Un documento può contenere tutte e tre le categorie contemporaneamente.
Questa distinzione conta perché una procedura capace di oscurare nomi e indirizzi non protegge necessariamente una ricetta industriale. Se un testo descrive una particolare combinazione di materiali utilizzata in una fabbrica, la rimozione dei riferimenti alle persone potrebbe essere irrilevante. Anche il contrario è vero: un documento apparentemente ordinario può diventare personale quando contiene informazioni che consentono di identificare un cliente attraverso il contesto.
Per un imprenditore, la prima attività utile consiste quindi nel conoscere quali tipi di informazioni passano per i diversi uffici. In amministrazione possono esserci dati fiscali, bancari e contrattuali. Nel commerciale compaiono listini riservati, sconti, condizioni speciali e nominativi. Nelle risorse umane circolano informazioni sui dipendenti. Nell’assistenza tecnica possono esserci registri degli interventi, indirizzi, numeri di serie e dettagli sui sistemi del cliente. Un unico divieto generico non aiuta le persone a riconoscere queste differenze.
Che cosa significa mascherare un testo prima di inviarlo al modello
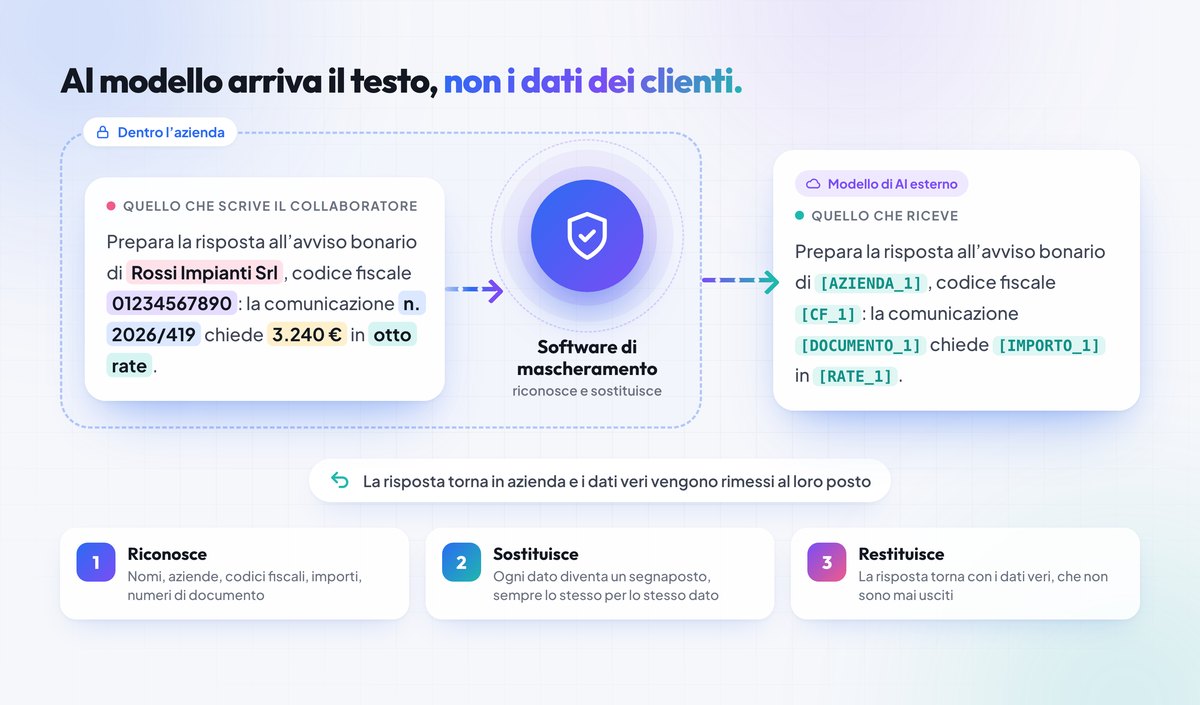
Una delle misure possibili è sostituire alcune informazioni con segnaposto prima di trasmettere il testo al sistema che deve elaborarlo. Per esempio, la frase «Mario Rossi di Rossi Impianti ha contestato la fattura 2026/419» può diventare «[REFERENTE_1] di [AZIENDA_1] ha contestato la fattura [DOCUMENTO_1]». Se il compito consiste nel migliorare il tono di una risposta o riordinare gli argomenti, il modello potrebbe svolgerlo senza conoscere i nomi reali.
La sostituzione deve preservare i collegamenti logici. Se Mario Rossi compare quattro volte nella stessa conversazione, il sistema dovrebbe sostituire ogni occorrenza con il medesimo segnaposto. Se compaiono due persone diverse, servono identificatori diversi. Altrimenti il modello rischia di confondere chi ha fatto una richiesta con chi deve approvarla. La stessa attenzione vale per aziende, documenti e altri elementi che si ripetono.
Alla fine del lavoro, un componente controllato dall’azienda può reinserire i valori originali nella bozza. La sostituzione inversa non deve essere affidata alla memoria del modello esterno: richiede una tabella di corrispondenza conservata in un ambiente autorizzato, con accessi regolati e una durata di conservazione definita. Prima dell’invio al cliente, la persona incaricata deve comunque leggere il testo e verificare che riferimenti, importi e destinatari siano corretti.
Questo processo viene spesso chiamato anonimizzazione, ma occorre essere rigorosi. Quando esiste una tabella che permette di recuperare i dati originali, in termini di protezione dei dati si è normalmente più vicini alla pseudonimizzazione. L’anonimizzazione, in senso proprio, richiede che non sia ragionevolmente possibile ricondurre i dati a una persona. Sono concetti differenti e non vanno confusi, soprattutto quando si descrive il livello di protezione ottenuto.
Il mascheramento è una riduzione dell’esposizione, non una garanzia assoluta. Un modello potrebbe identificare indirettamente qualcuno anche senza conoscerne il nome, se nel testo rimangono una posizione professionale unica, un evento pubblico, una località e una data molto specifica. Perciò bisogna valutare anche le informazioni che restano, non soltanto quelle che vengono sostituite.
Un esempio completo: dalla contestazione alla bozza di risposta
Consideriamo una simulazione inventata. Un’azienda riceve da un cliente una contestazione per materiale consegnato in ritardo. La mail contiene il nome del referente, due numeri di ordine, il prezzo complessivo della fornitura e la richiesta di applicare una penale prevista dal contratto. Il commerciale vorrebbe ottenere tre cose: una sintesi cronologica della vicenda, un elenco dei punti da verificare e una bozza di risposta che non ammetta responsabilità prima dei controlli interni.
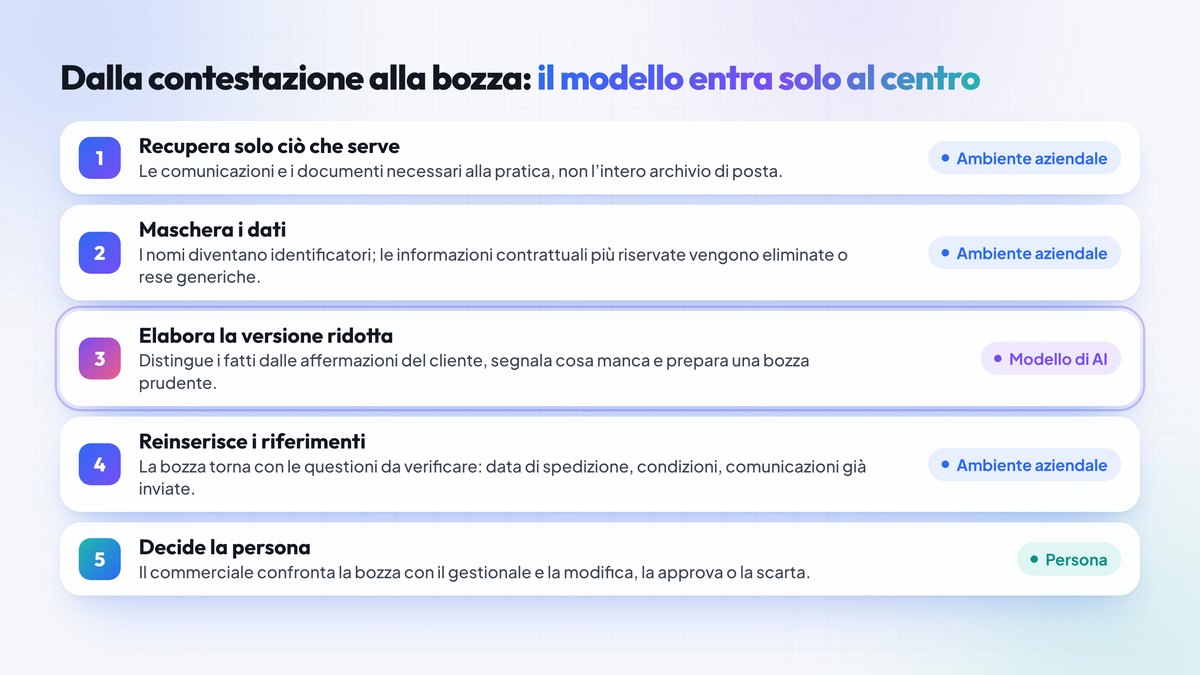
Il primo passaggio avviene nell’ambiente aziendale. Il sistema recupera soltanto le comunicazioni e i documenti necessari al compito, anziché l’intero archivio di posta. Questa scelta è importante: anche un ottimo sistema di mascheramento non giustifica l’accesso indiscriminato a informazioni che non servono. Le persone autorizzate a trattare quella pratica devono essere identificate prima dell’elaborazione.
Un componente locale o comunque collocato nell’ambiente controllato dell’organizzazione individua i dati da proteggere. I nomi diventano identificatori, i riferimenti documentali vengono sostituiti quando non sono necessari alla comprensione e le informazioni contrattuali più riservate vengono eliminate oppure rese generiche. Se la clausola specifica è indispensabile per rispondere, l’azienda deve valutare un’elaborazione in ambiente autorizzato; non si può presumere che qualunque clausola possa essere inviata a un fornitore esterno dopo avere cancellato il nome del cliente.
Il modello riceve quindi una versione ridotta della conversazione. La sua istruzione può essere formulata con precisione: deve distinguere i fatti confermati dalle affermazioni del cliente, segnalare quali informazioni mancano e preparare una bozza prudente senza aggiungere date, impegni o concessioni economiche che non compaiono nei materiali forniti. Se una parte è ambigua, deve evidenziarla anziché inventare una spiegazione.
La risposta torna nell’ambiente aziendale. Il sistema reinserisce i riferimenti consentiti, poi presenta al commerciale sia la bozza sia le questioni da verificare: data effettiva di spedizione, condizioni contrattuali applicabili e comunicazioni già inviate. Il commerciale confronta la bozza con il gestionale e decide se modificarla, approvarla o scartarla. La responsabilità della comunicazione rimane in azienda.
Nessun numero di risparmio è implicito in questo esempio. La convenienza va misurata sul processo reale, considerando il tempo impiegato per preparare la risposta e quello necessario per controllarla. Se il controllo è lungo quanto la scrittura manuale, l’automazione può avere comunque un valore organizzativo, ma non va presentata come un risparmio di ore già dimostrato.
Quando il mascheramento può compromettere il lavoro
Una protezione costruita senza capire il compito può rendere il modello inutilizzabile. Immagina di chiedere un controllo contabile e di sostituire tutti gli importi con la stessa parola «[IMPORTO]». Il sistema non potrebbe più verificare se il totale corrisponde alla somma delle righe. Se si devono controllare scadenze, togliere tutte le date impedisce di calcolare correttamente gli intervalli. Se il compito riguarda l’applicazione di una clausola, eliminare il contenuto della clausola significa togliere proprio l’informazione necessaria.
La soluzione richiede una progettazione per attività. Per una riscrittura stilistica possono essere sufficienti segnaposto generici. Per una verifica matematica potrebbero servire i valori numerici, ma non necessariamente il nome della persona a cui si riferiscono. Per una valutazione giuridica o fiscale, invece, alcune informazioni contestuali possono essere indispensabili e occorre decidere se utilizzare un ambiente che possa trattarle legittimamente. La scelta va fatta prima dell’invio, non dopo avere constatato che la risposta non funziona.
Conviene anche distinguere tra dati che identificano una persona e dati che identificano un documento. Un numero di fattura non è sempre, da solo, un dato personale, ma può diventare un identificatore nella disponibilità di chi conosce il sistema aziendale. Sostituirlo potrebbe essere prudente in una circostanza e superfluo in un’altra. Non esiste una lista di parole da oscurare valida per tutte le organizzazioni.
Per questo è utile testare il comportamento del sistema su casi realistici ma costruiti artificialmente. Si preparano richieste semplici, casi con più interlocutori, messaggi che contengono allegati e situazioni in cui un dato identificativo compare in forme diverse. Si verifica poi se i segnaposto rimangono coerenti, se il contenuto conserva il significato e se la reintroduzione dei valori originali produce un testo corretto.
Perché la scelta del fornitore continua a essere importante
Un buon mascheramento non rende irrilevante il servizio esterno utilizzato. Prima di collegare un modello ai documenti aziendali, occorre sapere chi è il fornitore, quali dati vengono trasmessi, per quali finalità sono utilizzati, dove vengono trattati e quanto tempo possono essere conservati. Servono anche informazioni sui soggetti che eventualmente partecipano al trattamento e sui meccanismi di sicurezza applicati.
La verifica deve riguardare il servizio concreto e il tipo di account. Un abbonamento individuale, un ambiente aziendale amministrato centralmente e un collegamento tramite interfaccia per sviluppatori possono prevedere condizioni diverse. Non basta avere sentito dire che un determinato marchio «non usa i dati per addestrare l’AI»: bisogna leggere le condizioni pertinenti e capire se riguardano esattamente la configurazione che l’azienda intende adottare.
Se vengono trattati dati personali, il responsabile aziendale della privacy e gli eventuali consulenti devono valutare ruoli, basi giuridiche, accordi, trasferimenti e misure di sicurezza. Il GDPR non si esaurisce nell’ubicazione fisica di un server. Un servizio ospitato in Europa può comunque prevedere accessi o trasferimenti che richiedono valutazioni; allo stesso modo, l’uso di un fornitore extraeuropeo non può essere giudicato sulla sola nazionalità senza esaminare il meccanismo giuridico e tecnico applicabile.
La decisione deve coinvolgere anche chi gestisce l’informatica. Una soluzione può avere buone condizioni contrattuali ed essere configurata male: autorizzazioni troppo ampie, chiavi di accesso condivise, assenza di registrazioni delle operazioni o copie conservate senza necessità. Proteggere un dato durante la chiamata al modello è una parte del lavoro; il resto del percorso conta altrettanto.
I documenti che il sistema può leggere devono essere quelli necessari
Molte integrazioni promettono di collegare in pochi minuti l’intelligenza artificiale alla posta, alle cartelle condivise e ai programmi aziendali. Dal punto di vista operativo questa comodità è interessante, ma bisogna chiedersi quali autorizzazioni vengono concesse. Per rispondere alla mail di un singolo cliente non dovrebbe essere necessario leggere tutti i messaggi di ogni dipendente. Per preparare un riepilogo delle fatture di un ufficio non dovrebbe servire accesso ai documenti del personale.
Il principio pratico è limitare gli accessi al minimo necessario. Ogni strumento deve avere soltanto i permessi che servono al proprio compito e, quando possibile, utilizzare credenziali dedicate. Le operazioni di sola lettura vanno distinte da quelle che consentono di modificare, cancellare o inviare contenuti. Un assistente che prepara bozze può essere molto utile senza avere il permesso di spedirle automaticamente.
È opportuno registrare chi ha autorizzato il collegamento, quali fonti sono disponibili e chi può modificarne la configurazione. Se cambia il ruolo di un dipendente o termina un rapporto con un fornitore, deve essere possibile revocare gli accessi. Questa organizzazione non è un dettaglio tecnico: determina quali informazioni un sistema può effettivamente utilizzare.
Anche gli allegati meritano attenzione. Un PDF può contenere metadati, immagini di documenti, firme e informazioni non visibili nel testo estratto. Una scansione può rendere difficile riconoscere correttamente alcuni dati. Prima di affidare all’automazione la protezione degli allegati, bisogna verificarne le capacità su formati e qualità di documenti simili a quelli usati davvero in azienda.
Un approccio possibile: elaborazioni locali e servizi esterni controllati
Non tutti i compiti richiedono lo stesso modello. Alcune attività semplici, come riconoscere la tipologia di una richiesta o estrarre campi da documenti con struttura regolare, possono essere affrontate con strumenti relativamente piccoli. Altre, come ricostruire una conversazione articolata o confrontare testi complessi, possono richiedere strumenti più capaci. La scelta dipende dalla qualità necessaria, dal volume di lavoro e dal livello di riservatezza delle informazioni.
Un’architettura ibrida permette di collocare alcune elaborazioni nell’infrastruttura controllata dall’organizzazione e affidarne altre a servizi esterni dopo aver ridotto i dati trasmessi. Nel progetto VoiceMail, per esempio, la protezione delle informazioni personali è stata pensata come una componente centrale del flusso, anziché come un’operazione lasciata alla prudenza di chi scrive. La base documentale è crittografata e il progetto ha superato la verifica CASA di Google per l’accesso a Gmail.
Non serve trasformare ogni piccola azienda in un centro informatico. Serve individuare i processi nei quali l’intelligenza artificiale offre un vantaggio concreto e scegliere per ciascuno un percorso dei dati comprensibile e controllabile. Talvolta la scelta appropriata sarà una soluzione aziendale già pronta.
In altri casi sarà utile un sistema locale. In altri ancora una combinazione delle due modalità. Il costo di realizzazione e manutenzione va confrontato con il beneficio atteso, senza presumere che una macchina installata in ufficio sia automaticamente più economica o più sicura.
Come verificare che la protezione funzioni davvero
Una regola scritta e un software di mascheramento non bastano se nessuno controlla il risultato. Prima della messa in uso occorre definire alcune prove. Una riguarda il riconoscimento dei dati: su una raccolta di documenti di test, quanti nomi, indirizzi e altri identificatori vengono intercettati? Un’altra riguarda gli errori opposti: quante parole normali vengono oscurate inutilmente? Una terza verifica che la risposta mantenga i collegamenti corretti fra interlocutori e documenti.
Per valutare il rischio è utile distinguere almeno due tipi di errore. Il falso negativo è un’informazione che avrebbe dovuto essere mascherata e che invece rimane visibile. Il falso positivo è una parte di testo innocua che viene oscurata senza necessità. Il primo può esporre dati; il secondo può peggiorare la qualità della risposta. Per capire se la protezione è adeguata bisogna misurare entrambi, usando esempi che rispecchino il lavoro reale.
La verifica non finisce con l’installazione. Cambiano i modelli, cambiano i formati dei documenti e cambiano le persone che utilizzano gli strumenti. Una procedura valida per le email può rivelarsi insufficiente quando si comincia a elaborare foto di ordini scritti a mano. Serve quindi un responsabile che esamini gli incidenti, aggiorni le regole e decida quando un caso debba essere gestito manualmente.
Quando si verifica un problema, la domanda utile è che cosa sia accaduto lungo l’intero percorso. Il dato è stato acquisito correttamente? Il sistema di mascheramento ha riconosciuto il riferimento? Il modello ha ricevuto soltanto ciò che doveva? La ricostruzione finale ha reinserito il valore giusto? La persona incaricata ha controllato la bozza prima dell’invio? Questa ricostruzione rende possibili miglioramenti concreti.
Come introdurre una regola comprensibile a tutto il personale
Una piccola impresa non ha bisogno di cominciare con un manuale di cento pagine. Può partire da un documento breve che spieghi quali strumenti sono autorizzati, per quali attività e con quali informazioni. È utile includere esempi presi dal lavoro quotidiano: una email di sollecito senza dati personali, un contratto da riassumere, un elenco di clienti da analizzare e una procedura interna da trasformare in istruzioni.
Per ogni esempio bisogna indicare la strada corretta. Un testo pubblico può essere trattato con strumenti autorizzati per quell’uso. Una bozza contenente informazioni riservate richiede l’ambiente previsto dall’organizzazione e le necessarie valutazioni. Credenziali, password, segreti industriali e dati personali non devono essere copiati liberamente in strumenti personali soltanto perché l’interfaccia permette di farlo. Se un dipendente non sa classificare un documento, deve conoscere la persona a cui chiedere prima di inviarlo.
La formazione funziona meglio quando si mostra cosa accade realmente. Si può prendere un messaggio inventato, evidenziare le informazioni che identifica e far vedere come vengono sostituite. Poi si mostra una risposta prodotta dal modello e si chiede ai partecipanti di individuare eventuali errori. In questo modo il personale capisce sia l’utilità dell’assistente sia i limiti della protezione.
È importante che le persone possano raccontare come utilizzano già questi strumenti senza temere conseguenze automatiche. Spesso gli usi più rischiosi nascono da un’esigenza pratica: preparare una risposta prima, ritrovare un documento, evitare di ricopiare i dati. Se l’azienda conosce quell’esigenza, può offrire una procedura approvata. Se si limita a vietare senza spiegare, rischia di perdere visibilità sui comportamenti reali.
Le domande da porre prima di autorizzare un nuovo uso dell’AI
Prima di attivare una nuova funzione, descriverei il lavoro da svolgere con parole semplici. Quale documento viene letto? Chi è autorizzato a vederlo? Quali dati contiene? Che cosa viene inviato a un servizio esterno? Quali trasformazioni avvengono prima dell’invio? Dove viene conservata la tabella che collega segnaposto e informazioni originali? Chi controlla il risultato? Che cosa succede quando il sistema non riconosce un dato o produce una risposta incerta?
A queste domande operative aggiungerei quelle economiche. Quanto tempo richiede oggi l’attività? Quanto ne richiederà con l’assistente, includendo revisione e gestione delle eccezioni? Quanto costa sviluppare e mantenere la protezione? Ci sono situazioni in cui il lavoro peggiora perché i dati necessari vengono mascherati? Un progetto di intelligenza artificiale deve migliorare un processo verificabile e mantenere un livello di rischio accettabile.
Bisogna inoltre decidere quali azioni il sistema può compiere autonomamente. Leggere una richiesta e preparare un testo è diverso dal mandarlo al cliente, modificare un ordine o aggiornare un dato bancario. La progressione più prudente consiste nell’avviare il progetto con bozze e suggerimenti controllati dalle persone, raccogliere gli errori e ampliare l’autonomia solo quando esistono prove sufficienti della sua affidabilità.
Il ruolo delle persone rimane essenziale
La presenza di un controllo umano non dovrebbe essere una formula riportata in fondo alla procedura. Occorre stabilire chi controlla, su quali elementi e con quanto tempo a disposizione. Se l’addetto riceve una bozza ma non può confrontarla con la documentazione originale, il controllo è poco più che formale. Se invece può vedere i dati di partenza, gli elementi incerti e le modifiche introdotte dall’assistente, può assumere una decisione informata.
Un buon sistema dovrebbe rendere evidente quando mancano informazioni. Per esempio, se la mail del cliente menziona un accordo telefonico che non compare nei documenti, il modello dovrebbe segnalare la lacuna. Se una clausola può essere interpretata in più modi, dovrebbe evitare di presentare una sola interpretazione come certa. Se i dati sono stati oscurati e impediscono un controllo necessario, il flusso dovrebbe essere interrotto e rimandato a una persona o a un ambiente autorizzato.
Questa impostazione rende l’intelligenza artificiale utile senza nasconderne i limiti. Il sistema può alleggerire lettura, classificazione, ricerca e stesura, mentre le persone conservano la conoscenza del cliente, la valutazione degli impegni assunti e la responsabilità delle comunicazioni. Nel tempo possono anche migliorare le istruzioni, perché sono le prime a vedere quando una risposta apparentemente corretta non è adeguata alla situazione.
Un percorso di adozione che una PMI può sostenere
Per cominciare sceglierei un’attività frequente ma a rischio limitato, per esempio la preparazione di bozze di risposta a richieste ricorrenti. Raccoglierei alcuni esempi inventati che riproducono casi semplici ed eccezioni, chiedendo alle persone che svolgono il lavoro di descrivere come riconoscono una risposta adeguata. Solo dopo confronterei gli strumenti disponibili, l’ambiente di trattamento e le misure necessarie per proteggere i dati.
Durante la prova conserverei gli errori rilevati e le correzioni fatte, senza trasformare la sperimentazione in un utilizzo indiscriminato della posta reale. Le persone coinvolte dovrebbero sapere quali contenuti possono trattare e quali devono tenere fuori dal sistema. Il responsabile del progetto dovrebbe avere la possibilità di sospendere rapidamente l’accesso se emergono problemi, oltre a raccogliere osservazioni da chi utilizza lo strumento.
Dopo la prova confronterei il lavoro iniziale con quello nuovo. Valuterei la qualità delle risposte, il tempo totale richiesto, le informazioni che restano ancora da inserire manualmente e gli eventuali problemi di riservatezza. Soltanto con questi elementi deciderei se ampliare l’automazione ad altri uffici. Non ogni attività merita un collegamento all’intelligenza artificiale, e la capacità di rinunciare a un’automazione poco vantaggiosa è parte di una buona progettazione.
Il criterio finale resta comprensibile anche senza conoscere la tecnologia. Ogni azienda deve poter spiegare quali informazioni usa il proprio assistente, perché le usa, quali soggetti possono riceverle e chi è responsabile di verificare il risultato. Se a queste domande non si riesce a rispondere con precisione, significa che il processo non è ancora pronto per essere affidato al sistema.
Il vantaggio più duraturo per un’impresa
L’intelligenza artificiale può essere particolarmente utile proprio nei processi in cui circolano molti documenti. È lì che si accumulano ricerche, letture e copiature che sottraggono tempo al lavoro delle persone. Per usare questa opportunità occorre conoscere il percorso dei dati, ridurne la diffusione e progettare controlli proporzionati al compito.
Il mascheramento delle informazioni personali è una misura importante, purché venga descritto correttamente e verificato nella pratica. Non elimina da solo tutti i rischi, non sostituisce gli accordi con i fornitori e non autorizza la trasmissione indiscriminata dei documenti. Una protezione efficace combina limitazione degli accessi, minimizzazione delle informazioni, eventuale pseudonimizzazione, scelte contrattuali consapevoli e revisione umana del risultato.
Per un’impresa il vantaggio più duraturo è poter introdurre sistemi utili senza costringere i dipendenti a scegliere ogni giorno tra velocità e riservatezza. È un obiettivo che si raggiunge progettando il lavoro prima di collegare l’assistente ai documenti.
Parliamo della tua azienda.
Nella videocall gratuita di trenta minuti mi racconti come è organizzato il lavoro e ti dico se e come l’intelligenza artificiale può esserti utile, e da quale dei miei servizi partire.
Nella pagina dei casi trovi sei interventi raccontati con i numeri e il mio ruolo. Le guide gratuite sono tre: l’intelligenza artificiale per le aziende, quella per gli studi professionali e la guida all’AI Act.


